Kimi API
文档:请求示例 · 参数说明 · 错误码
结构化拆解 Kimi API 接口规范。从请求报文装配、流式 SSE 协议解析到 4xx/5xx 错误码精准映射,提供产品说明书般的严谨调用指南。
OpenAI 协议兼容
SSE 流式传输
200K 超长上下文
高并发限流熔断
01
Auth Header
02
Payload JSON
[03 / CORE]
Kimi API
INFERENCE ENGINE V3
04
SSE Stream Hub
05
Token Counter
EXPLODED ASSEMBLY VIEW // DIAGONAL AXIS
FIVE DISCRETE PARTS · NO OVERLAP
Kimi API 核心特性解构
基于爆炸图拆解思想,剖析请求链路中的关键组成部分
原生流式 SSE 推送
支持 Server-Sent Events 流式打字机实时下发,大幅降低首字延迟(TTFT),提升前端交互流畅度。
超长文本上下文解析
最高支持数十万字长上下文一次性输入,精准提炼海量文档、代码工程与专业论文关键信息。
全兼容 OpenAI 接口生态
无需重构业务调用逻辑,仅需替换 Base URL 与 API Key 即可将现有项目快速迁移至 Kimi 模型底座。
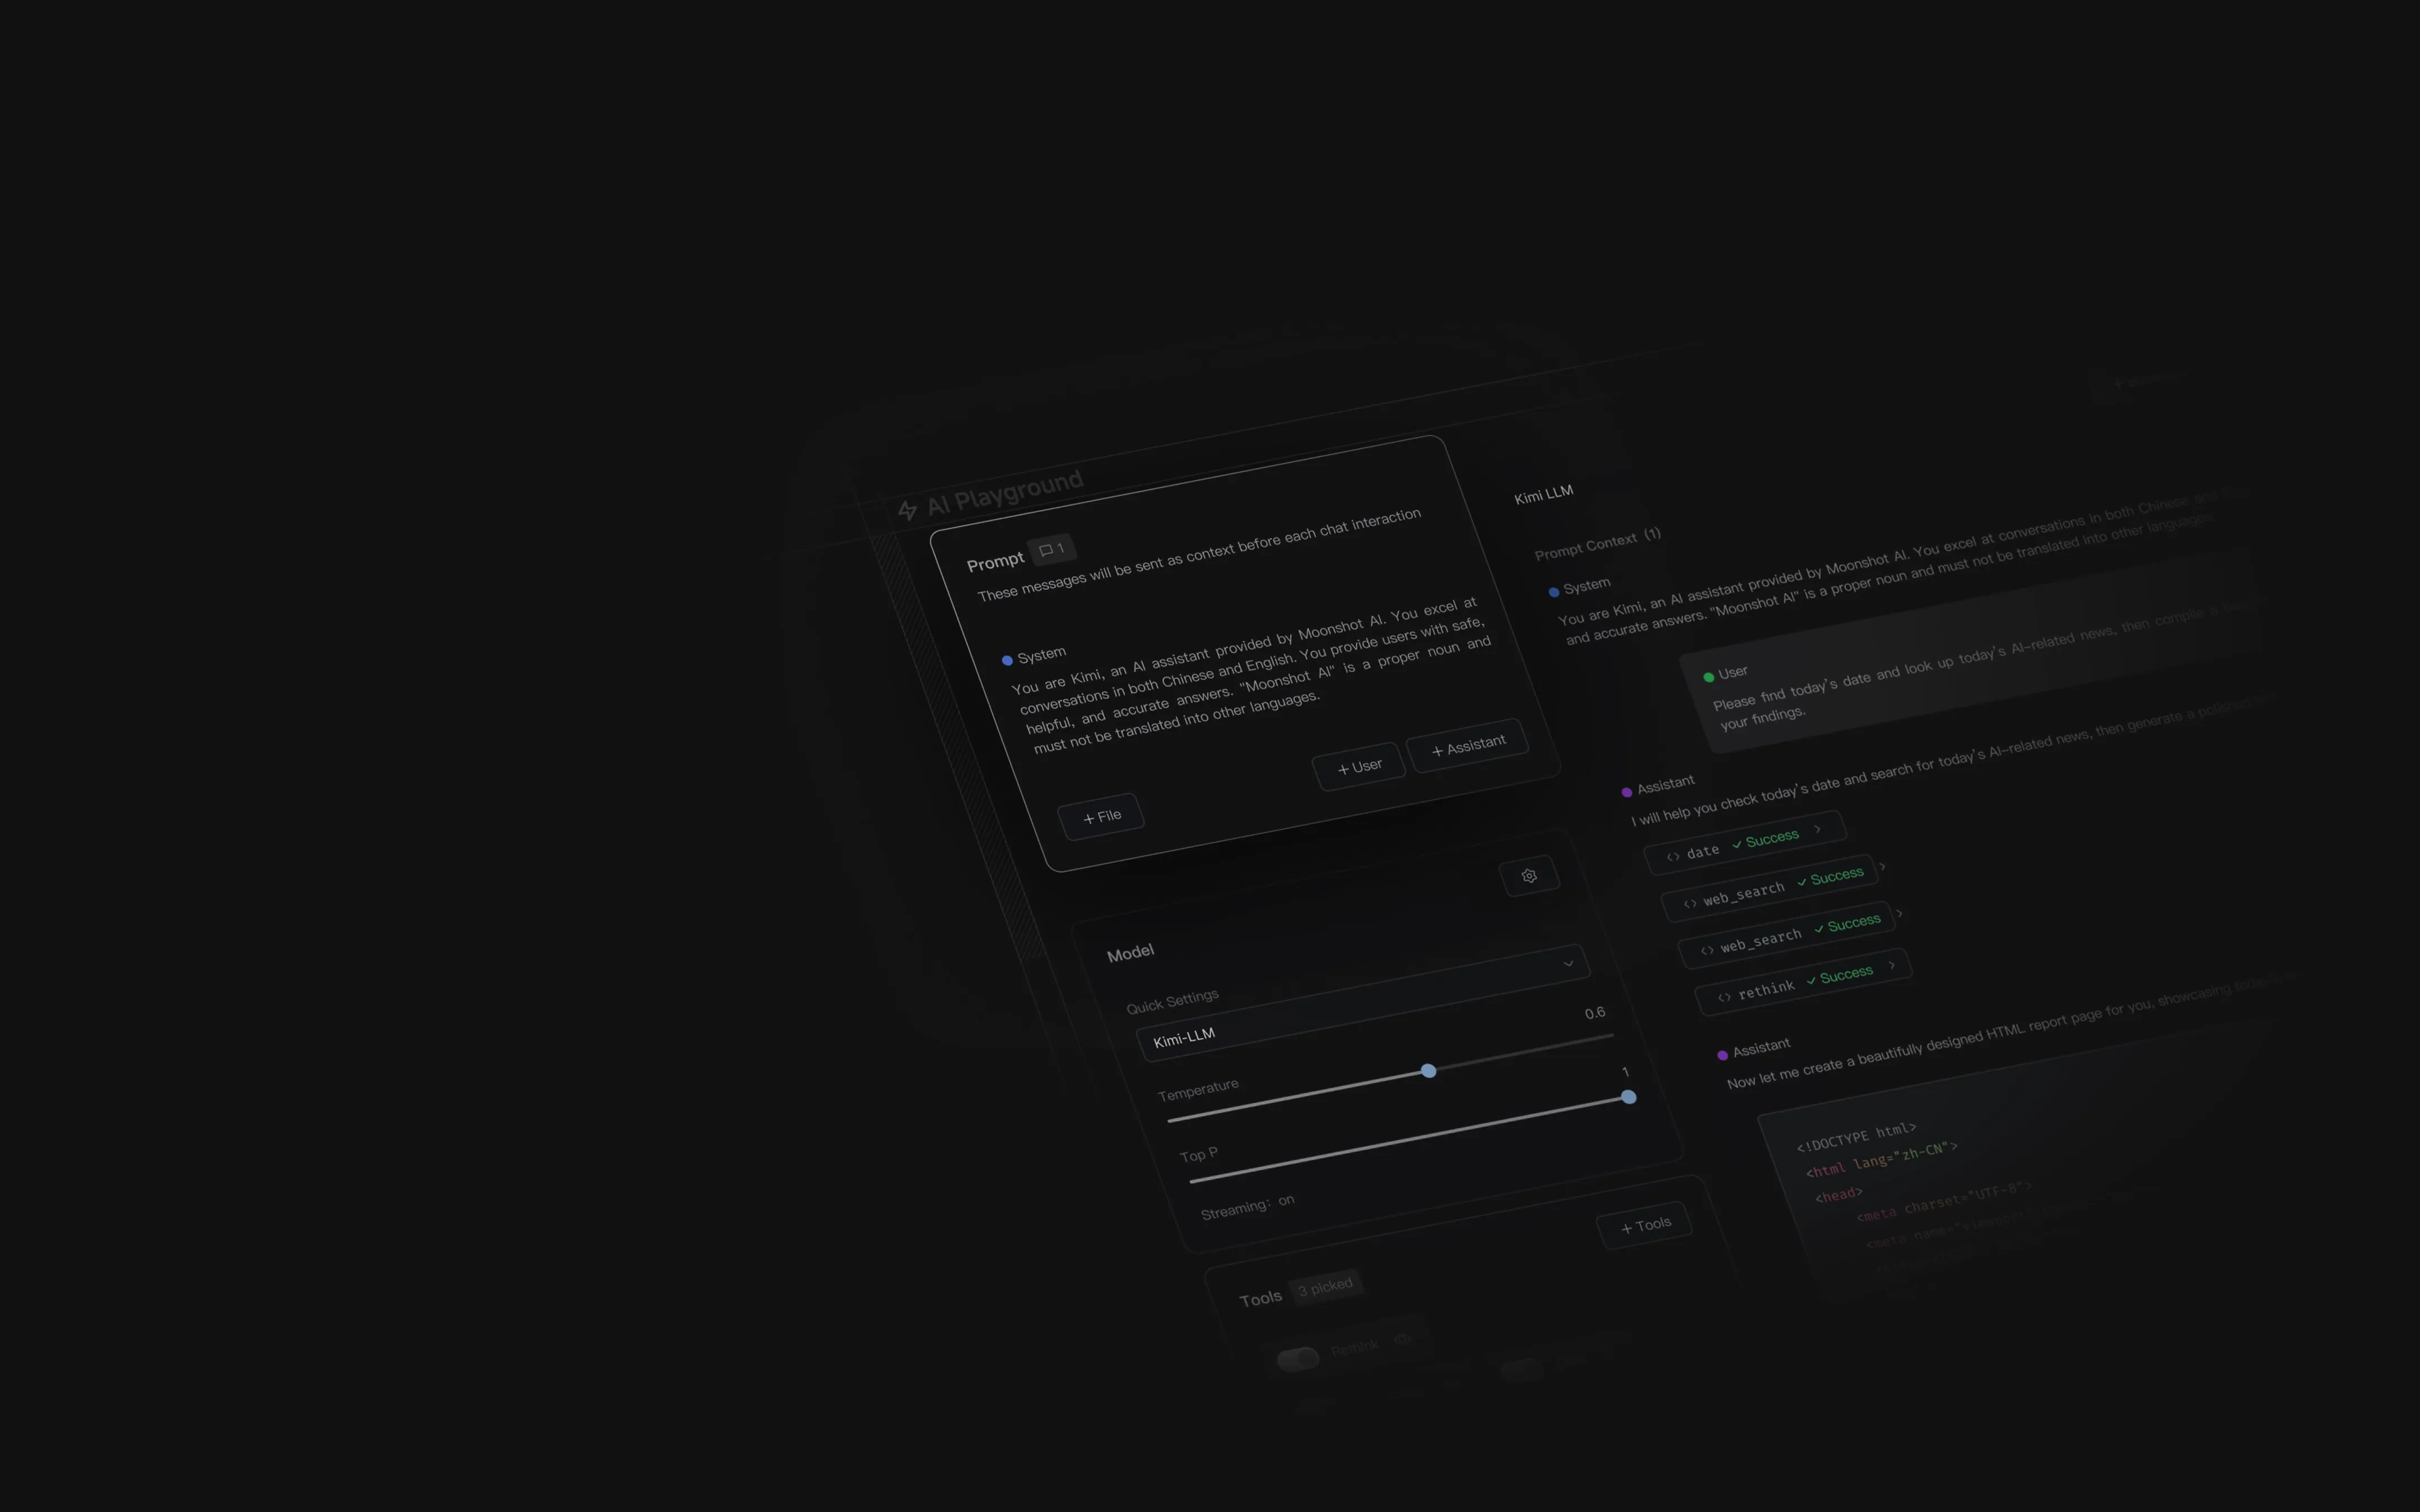
标准 cURL 请求示例
通过标准的 HTTP POST 请求调用 `/v1/chat/completions` 接口,支持多轮对话与角色历史传递。
curl https://api.moonshot.cn/v1/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $MOONSHOT_API_KEY" \
-d '{"model": "moonshot-v1-8k", "messages": [{"role": "user", "content": "你好"}]}'
-H "Content-Type: application/json" \
-H "Authorization: Bearer $MOONSHOT_API_KEY" \
-d '{"model": "moonshot-v1-8k", "messages": [{"role": "user", "content": "你好"}]}'
核心参数矩阵说明
精确控制 temperature、top_p、max_tokens 等超参数,适配结构化数据提取与长文创意生成不同场景。
{
"model": "moonshot-v1-32k",
"temperature": 0.3,
"stream": true
}
"model": "moonshot-v1-32k",
"temperature": 0.3,
"stream": true
}
Kimi API 快速接入四步法
从生成密钥到完成首笔多轮对话的规范路径
01
获取 API Key
登录控制台创建业务专属应用并生成具有调用权限的 API Key,写入系统环境变量。
02
装配请求报文
构造标准 JSON 请求体,指定目标模型版本并组装 `system` 与 `user` 的 messages 数组。
03
发起 HTTP 交互
向官方端点发送携带 Bearer Token 的 POST 请求,开启流式监听处理增量 token。
04
解析用量与排错
读取响应体尾部的 usage 统计,捕获异常状态码并执行退避重试或业务降级逻辑。
API 请求常见漏做项对照表
开发联调期间的高频失误与标准工程实现
接口调用审查对照
API CHECKLIST 2026| 调用环节 | 常见不规范漏做项 | 标准规范实现方案 |
|---|---|---|
| 密钥存储 | [风险] 将 API Key 明文硬编码提交到 Git 仓库 | [标准] 使用环境变量(ENV)或密钥管理中心动态注入 |
| 超时控制 | [缺陷] 使用默认无超时设置导致连接池被挂起 | [标准] 设置 60s 读取超时与 10s 建连超时 |
| 错误重试 | [缺陷] 遇到 429 立即并发重试加剧拥塞 | [标准] 采用指数退避算法并添加随机 Jitter 延时 |
| 流式解析 | [缺陷] 忽略 `data: [DONE]` 终止符导致连接悬挂 | [标准] 严格监听 `[DONE]` 标志并主动释放 SSE 连接 |
多岗位 API 应用场景
不同研发角色基于 Kimi API 的落地焦点
全栈开发工程师
“在 Web 端集成流式打字机效果,结合 Markdown 渲染器实现实时对话界面。”
核心操作:处理 SSE 数据流并进行前端流式增量渲染
数据中台工程师
“批量向模型灌入企业研报与财报长文档,提取结构化 JSON 实体并落入数据库。”
核心操作:利用超长上下文批量解析与提示词结构化输出约束
AI 智能体开发者
“通过定义多轮 messages 数组与工具定义,驱动 Agent 自动规划和多步推理。”
核心操作:管理长期记忆窗口与构建多轮会话状态机
系统运维/SRE
“监控 API 网关调用的 5xx 错误率与 P99 延迟,配置微服务熔断与限流。”
核心操作:采集 x-request-id 与分析 HTTP 状态码分布
Kimi API 实用开发小技巧
来自生产环境的调优与工程建议
TIP #01
合理利用 system 角色
在 messages 头部注入系统角色指令,明确模型语气、输出格式限制与边界规则。
TIP #02
复用 HTTP Keep-Alive 连接
在客户端保持 TCP 连接复用,可省去每次请求的 TLS 握手开销,降低请求耗时 100ms+。
TIP #03
监控 usage 优化 Prompt
定期统计输入 Token 与输出 Token 的占比,精简冗余背景描述,直接降低运营成本。
常见报错与排障处理顺序
定位异常现象,按工程化步骤逐项排查
现象一:HTTP 401 Unauthorized 认证失败
排查顺序:
- 检查请求头 `Authorization` 是否漏掉了 `Bearer ` 前缀;
- 检查当前 API Key 是否已在控制台被删除或禁用;
- 确认环境变量读取到的字符串是否包含首尾换行符或空格。
现象二:HTTP 429 Too Many Requests 频率超限
排查顺序:
- 检查短时间内并发请求是否超出了账户的每分钟请求数(RPM)限制;
- 检查单次发送的长上下文是否超出了每分钟 Token 数(TPM)配额;
- 在业务端接入队列缓冲与指数退避重试,并申请提升并发额度。
现象三:HTTP 500 / 503 服务端内部错误或超时
排查顺序:
- 记录该次请求返回头部的 `x-request-id` 链路追踪标识;
- 使用指数退避算法进行 1~2 次安全重试;
- 若持续报错,登录控制台帮助中心提交工单附带 `x-request-id`。
常见问题解答 (FAQ)
涵盖 API 鉴权、参数配置及错误排查的完整问句
Kimi API 的标准 Base URL 与鉴权 Header 格式是什么?
Kimi API 基础调用地址为 `https://api.moonshot.cn/v1`,使用 HTTP Bearer Token 鉴权,请求头中必须包含 `Authorization: Bearer YOUR_API_KEY`。
如何通过 cURL 或 Python SDK 发起首笔流式(stream)聊天补全请求?
向 `/v1/chat/completions` 发送 POST 请求,在 JSON 请求体中设置 `stream: true` 并传入 `messages` 数组,服务端将以 SSE(Server-Sent Events)格式逐块推送增量内容。
Kimi API 核心参数 temperature 与 top_p 如何配合调优?
通常建议二选一调节。在需要严谨事实推演与代码生成的任务中建议将 temperature 设为 0.1~0.3;在创意写作或灵感发散任务中可设为 0.7~0.9。
当接口返回 400 invalid_request_error 时主要由哪些原因导致?
常见原因包括 JSON 语法错误、messages 数组为空、传入了不支持的模型名称或请求上下文长度超过了该模型的 Token 上限。
当接口返回 429 rate_limit_exceeded 时应采取何种退避策略?
建议在客户端引入带有随机抖动(Jitter)的指数退避重试算法,并在开放平台控制台提交申请提高账户的 RPM 与 TPM 配额。
Kimi API 是否兼容 OpenAI 标准 SDK 格式?
兼容。直接使用 OpenAI 官方 Python 或 Node.js 客户端时,仅需将 `base_url` 修改为 `https://api.moonshot.cn/v1` 并传入 Kimi API Key 即可无缝切换。
Kimi API 支持的最大上下文窗口与单次输出限制是多少?
标准模型支持最高 128k/200k 超长上下文输入,单次最大生成输出 Token 数量支持在请求参数中通过 `max_tokens` 自定义设定。
接口响应体中的 usage 字段如何统计 Token 计费?
响应体包含 `prompt_tokens`(输入提示词消耗)、`completion_tokens`(模型生成消耗)以及 `total_tokens`(总计消耗),计费以此精确统计。
Kimi API 最新技术资讯
紧跟接口规范、模型迭代与 SDK 发布动态
准备好发起首个 Kimi API 请求了吗?
遵循标准化接入四步法,快速集成大模型推理能力,构建下一代智能应用。
立即查看接入步骤